Em uma base central com 32,5 milhões de registros de pessoas, uma busca simples por um nome revelou o tamanho do problema: um mesmo indivíduo aparecia 82 vezes, com grafias, datas de nascimento e documentos divergentes. Não era fraude nem erro isolado. Cada registro estava correto para o sistema que o criou; o problema só aparecia quando alguém tentava enxergar a pessoa inteira.
O caso abre o white paper Uma pessoa, 82 registros, em que a Vert Analytics reúne aprendizados de projetos recentes de qualidade e governança de dados em organizações de grande porte do setor público brasileiro, com bases que vão de dezenas de milhões a bilhões de registros. Nomes de clientes foram omitidos e os dados pessoais do documento são fictícios.
Por que dado ruim custa caro mesmo sem aparecer no orçamento?
Ninguém aprova verba para “dados duplicados”, mas a conta é paga todos os dias: no analista que passa a manhã conciliando planilhas, na investigação que não conecta dois registros da mesma pessoa, no indicador que conta o mesmo cidadão três vezes. O Gartner estima que a baixa qualidade de dados custa, em média, pelo menos US$ 12,9 milhões por ano a cada organização. Na pesquisa global da McKinsey, executivos relataram que 30% do tempo das equipes ia para tarefas sem valor causadas por dados ruins ou indisponíveis.
A inteligência artificial eleva a aposta. Segundo o Gartner, até 2026, 60% dos projetos de IA sem dados preparados devem ser abandonados. Modelos aprendem com o que recebem: dados fragmentados produzem respostas fragmentadas.
De 32,5 milhões de registros para 11,9 milhões de pessoas
A fragmentação nasce de forças presentes em quase toda organização grande: ausência de uma chave comum (o CPF nem sempre está lá), campos livres sem validação, formatos legados, integrações feitas por cópia e correções que ficam no relatório em vez de voltar à origem. O resultado era uma média de 2,7 registros para cada pessoa real, o que infla indicadores, esconde vínculos e faz cada consulta processar quase três vezes mais linhas do que o necessário.
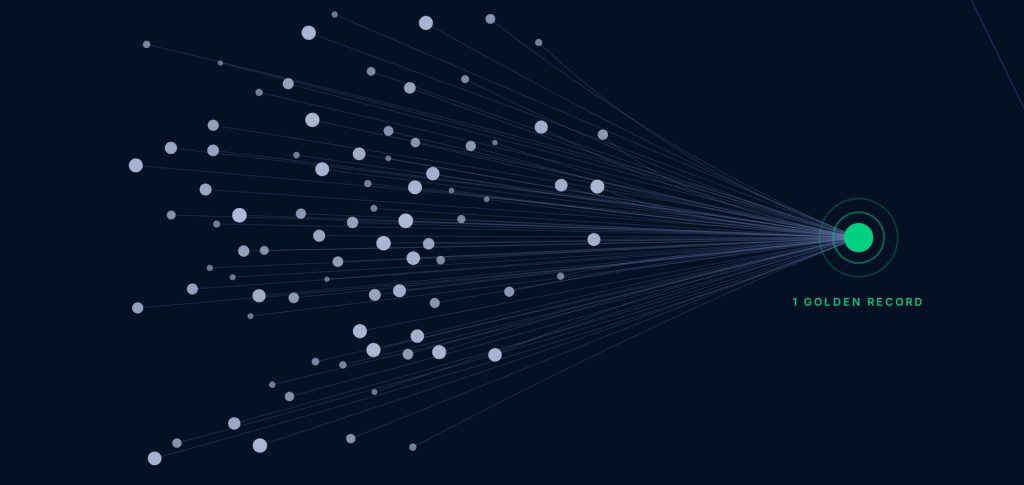
A resposta combinou padronização, deduplicação e gestão de dados mestres. A base convergiu para 11,9 milhões de pessoas únicas, 63% menos registros, cada uma representada por um golden record: a versão única e confiável da entidade, que aponta para todos os registros de origem sem apagar nenhum deles, o que permite auditar e desfazer vínculos equivocados.
Um endereço sem coordenadas não existe no mapa
O mesmo raciocínio vale para endereços. No ponto de partida, 35 milhões de endereços não tinham latitude e longitude, e 85% deles também não tinham CEP, o que impedia o atalho da geocodificação pelo código postal. Tratar o endereço como dado mestre, padronizando antes de geocodificar e validando antes de gravar, permitiu georreferenciar os 35 milhões.
Seis blocos, não uma ferramenta
Uma limpeza pontual melhora a base por alguns meses; sem regras, responsáveis e monitoramento, a desordem volta. O white paper descreve um programa de seis blocos organizados em três camadas: corrigir o dado, consolidar a verdade e sustentar a confiança.
- Padronização: um jeito só de escrever cada nome, data, documento e endereço, sem perder o valor original.
- Deduplicação: regras determinísticas e comparação probabilística para decidir, em escala, quais registros descrevem a mesma entidade, com revisão humana nos casos ambíguos.
- Gestão de dados mestres: o golden record, com regras explícitas sobre qual valor prevalece em cada atributo e de onde ele veio.
- Regras de qualidade: dez dimensões, da acurácia à acessibilidade, consolidadas em um índice por domínio.
- Monitoramento e observabilidade: atualidade, volume, esquema e distribuição acompanhados continuamente, com alertas antes que o problema chegue a um painel ou a um modelo.
- Governança e metadados: catálogo, glossário, linhagem de ponta a ponta e donos nomeados para cada ativo crítico.
Onde a qualidade de dados vira inteligência fiscal
Na administração tributária, a fraude raramente está em um cadastro isolado: está nos vínculos entre sócios, endereços, contadores e notas fiscais. A análise de redes de relacionamento só funciona sobre entidades bem identificadas. Se o mesmo sócio aparece como três nós, o articulador do esquema se perde no ruído; se homônimos são unidos sem critério, um contribuinte regular passa a parecer parte de um esquema. Com entidades padronizadas, os mesmos vínculos passam a apontar para as entidades certas, e o padrão aparece.
Como começar: ondas, não big bang
Programas de dados fracassam quando tentam abraçar a organização inteira de uma vez. O caminho recomendado é concentrar o esforço inicial em dois ou três domínios prioritários (pessoas e endereços costumam ser os que mais alavancam análises), medir o progresso com indicadores claros e expandir em ondas. O documento propõe 15 indicadores, da taxa de duplicidade ao tempo de resolução de incidentes, e mostra um plano real de implantação de plataforma de metadados em 31 semanas.
O white paper completo, com os quadros, as regras de exemplo e o painel de métricas, está disponível para download gratuito.